基本概念
数据可以存储在文件中,但数据库更安全、便于管理查询和程序访问。数据库本质上是一套数据存储的解决方案,底层还是依托文件进行存储。
数据库通过网络的形式提供服务。用户通过客户端访问服务端,服务端对数据库进行增删查改的操作,再将结果返回给客户端。
mysql -h 127.0.0.1 -P 3306 -u root -p123456
MySQL中,创建数据库本质就是创建一个目录,创建表本质就是在目录中创建文件,增删查改也就是访问该文件。
MySQL是关系型数据库,数据存储是按行列存储的。通常把一行称为记录,一列称为属性。

最底层是磁盘文件系统,往上是存储引擎,存储引擎是系统文件的封装,帮助我们进行文件操作。其上还有分析器,对SQL语句分析翻译成文件操作。
| SQL分类 | 解释 |
|---|---|
| DDL数据定义语言 | 用来维护存储数据的结构,如:create、drop、alter |
| DML数据操纵语言 | 对数据进行操作增删查改,如:insert、delete、update、select |
| DCL数据控制语言 | 负责权限管理和事务管理,如:grant、revoke、commit |
1. 库表操作
1.1 库的操作
创建库
create database `db_name`;create database if not exists `db_name` charset=utf8 collate utf8_general_ci;
create database [if not exists] db_name [specification, ...]
specification:
[default] character set charset_name ## 指定数据库采用的字符集
[default] collate set collation_name ## 指定数据库字符集的校验规则展示库
show datbases; ## 显示数据库
show create database `db_name`; ## 显示创建语句
删除库
drop database `db_name`;使用库
use `db_name`;查看连接情况
show processlist;存储规则和校验规则
show variables like 'character_set_database';
show variables like 'collation_database';
## 如果存储规则是utf8,校验规则就应是utf8_general_ci。
## 校验规则表示如何看待数据库中的数据,二者应该对应。
备份数据库
mysqldump -P3306 -u root -p123456 -B `db_name` > backup_file恢复数据库
source backup_file;1.2 表的操作
创建表
create table [if not exists] `tb_name` (
	field1 datatype,
    field2 datatype,
	field3 datatype
) [character set 字符集 collate 校验规则 engine 存储引擎];
删除表
drop table `tb_name`;查看所有表
show tables;
show create database `tb_name`; ## 查看创建表的语句
查看表结构
desc `tb_name`;更改表名称
alter table `old_name` rename to `new_name`;添加列
alter table `tb_name` add (`field_name2` datatype, ...) after `field_name1`删除列
alter table `tb_name` drop (`field_name` datatype, ...)修改列
alter table `tb_name` modify (`field_name` datatype, ...)
## 修改列会覆盖列的原有属性
更改列名称
alter table `tb_name` change `old_name` `new_name` datatype;
## 改列名也会覆盖列的原有属性
2. 数据类型
| 分类 | 数据类型 | 解释 |
|---|---|---|
| 数值类型 | BIT (M) | 位类型。M位数,默认为1范围1-64 |
| BOOL | 01表示真假 | |
| TINYINT [UNSIGNED] | 8位整型 | |
| SMALLINT [UNDIGNED] | 16位短整型 | |
| INT [UNSIGNED] | 32位整型 | |
| BIGINT [UNSIGNED] | 64位长整型 | |
| 小数类型 | FLOAT [ (M, D) ] [UNSIGNED] | 32位浮点类型,M整体长度,D小数长度 |
| DOUBLE [ (M, D) ] [UNSIGNED] | 64位浮点类型,M整体长度,D小数长度 | |
| DECIMAL (M, D) [UNSIGNED] | M整体长度,D小数位数 | |
| 文本、二进制类型 | CHAR (SIZE) | 定长字符串,L字符个数,最大255字符 |
| VARCHAR (SIZE) | 变长字符串,L字符个数,最大65535字节 | |
| BLOB | 二进制数据 | |
| TEXT | 大文本,不支持全文索引,不支持默认值 | |
| 时间日期 | DATE | yyyy-mm-dd仅日期格式,占3字节 |
| DATETIME | yyyy-mm-dd hh:mm:ss格式,支持自定义,占8字节 | |
| TIMESTAMP | yyyy-mm-dd hh:mm:ss格式,实际是时间戳,占4字节 | |
| String类型 | ENUM | 单个字符串对象,多选一 |
| SET | 字符串对象集合,多选多 |
2.1 数值
ERROR 1264 (22003): Out of range value for column 'number' at row 1SQL会直接拒绝插入越界的数据。数据类型本质就是一种数据安全的约束。
- float(4,2)的范围是:-99.99~99.99,小数会自动四舍五入,大小越界报错。
- float(4,2) usigned范围是:0~99.99,正数表示范围不变。
- float小数默认显示2位,整数超过9999990只能存到9999990。
- float小数设置超过7位存在精度损失,decimal小数精度更高。
- decimal小数精度最大30位,整体最大65位。D默认为0,M默认为10。
2.2 字符串
- varchar最大65535个字节,头3字节存储长度,故utf8编码varchar最大存储21844个字符。当然MySQL限制一行元素大小之和最大65535个字节。
- char类型始终占用L个字符的大小,varchar类型的占用和数据长度相关。
- 数据长度不变就用char,长度变化就用varchar;
- 定长浪费空间但效率高,变长节省空间但效率低。
2.3 enum和set
enum ('选项1', '选项2', '选项3', ...)新增时必须插入规定的选项值中的一个。enum类型,实际存储的是从1开始的数字下标。
set ('选项1', '选项2', '选项3', ...)set类型可以选择多个选项,用逗号隔开,合并成一个字符串。

set存储时采用位图结构。下标的二进制位,从低到高每个比特位表示一个选项,为1表示具有该选项,反之则没有。

where只能筛选出严格匹配的记录,用find_in_set可以筛选出包含该选项的记录。

3. 表的约束
MySQL为保证数据的完整性一致性,给我们提供了如下各种强约束。
3.1 空属性
MySQL中的NULL表示不存在、为空。列默认可以为空,not null表示不许为空。
create table stu (
	name varchar(16) not null
);
3.2 默认值
通过default设置列的默认值,可以避免该字段为空。
create table genders (
	gender char(1) default '男'
);
3.3 列描述
comment就是注释。
create table genders (
	gender char(1) comment '性别'
);
3.4 零填充
建表时MySQL自动为int字段添加(10)。设置zerofill的列,如果数据宽度低于指定位数,显示时会在前面补零,不影响存储。
alter table tb modify a(3) int unsigned zerofill;
select * from tbs;
+-----+
| a   |
+-----+
| 001 |
| 011 |
| 111 |
+-----+
3.5 主键
数据库要求表中有一个字段作为一行记录的唯一标识,就是主键。
类似于序号,根据主键能够唯一筛选出一条记录。主键字段不可为空不可重复,一张表只能有一个主键。
create table tb (
	id int primary key
);
删除主键
alter table `tb_name` drop primary key; ## 只是为字段去掉主键约束,并不是删除整列。追加主键
alter table `tb_name` add primary key(`field_name`); ## 为已存在字段追加主键,如果有重复值,会追加失败。复合主键
复合主键可以让多列合起来作为主键。这样只需要保证多列不同时重复就行。
create table `tb_name` (
	`field1` type,
	`field2` type,
	primary key (`field1`, `field2`, ...) ## 设置复合主键
);
3.6 自增长
设置auto_increment的字段,插入时可以不给值,新记录的会自动取值为当前最大值加1。一般自增长的字段都是主键。
create table tb (
	id int primary key auto_increment
) auto_increment=100;- 自增长字段默认从1开始,也可以插入数据,只要不重复即可。之后会从最大值开始递增。
- 被自增长的字段必须作为主键或者其他具有唯一性的键使用。
3.7 唯一键
如果存在多个字段需要保证唯一性,但主键只有一个,所以只能用唯一键约束。
create table stu (
	id1 int primary key,
	id2 int unique
);- 唯一键允许为空,NULL表示不参与运算。如果将唯一键设置为not null则自动转换成主键。
- 主键因索引而唯一,唯一键因业务而唯一。
- 主键只能有一个,唯一键能设置多个。
主键和唯一键并不冲突,只是负责数据在不同层面的唯一性。
3.8 外键
外键用来将从表和主表之间建立关系。外键定义在从表上,一般外键就对应着主表的主键或者唯一键。
create table tb (
	foreign key (`field`) references `tb_master`(`field`)
)
通过外键产生关系的表,除了在逻辑上有关联,MySQL也会维护该逻辑对用户操作产生约束。
比如班级表中得先有id为30的班级,才能在学生表中添加class_id为30的学生。
要删除班级表中id为20的班级,首先必须保证学生表中没有对应班级的学生。
对于数据库用户来说,外键是为了方便业务关联,对于MySQL来说,外键是为了产生对应的外键约束,保证数据的安全。
4. 增删查改
CRUD : Create(创建), Retrieve(读取),Update(更新),Delete(删除)
4.1 Create
insert into `tb_name` (column, ...) values
	(value_list),
	(value_list),
	...;
多行插入
insert into `tb_name` (column, ...) values
	(`data1`, `data2`, `data3`),
	(`data1`, `data2`, `data3`);
全列插入
insert into `tb_name` values (`data1`, `data2`, `data3`);指定列插入
insert into `tb_name` (`field1`, `field2`) values (`data1`, `data2`);插入否则更新
主键或者唯一键具有唯一性,可能会导致我们后续插入数据失败的问题。插入否则更新即插入成功就插入,如果失败就是更新。
insert into `tb_name` (`field1`, `field2`, ...) values (`data1`, `data2`, ...)
	on duplicate key update `field1`=`data1`, `field2`=`data2`, ...;
替换
替换就是不冲突就插入,冲突就替换,可能替换多行。
replace into `tb_name` (`field1`, `field2`, ...) values (`data1`, `data2`, ...);4.2 Retrieve
select
	[distinct]
	*
	[from `tb_name`]
	[where ...]
	[order by colum [asc | desc], ...]
	limit ...
全列查询
select * from `tb_name`;指定列查询
select `field1`, `field2`,... from `tb_name`;添加表达式查询
select `field1`, `field2`, `expression` as `alias_name` from `tb_name`;为字段起别名
select `field` as `alias_name` from `tb_name`;结果去重
是否重复是对整条记录而言。
select distinct `field1`, `field2`, ... from `tb_name`;结果排序
select `field1`, `field2` [, ...] from `tb_name` order by `field` asc;  ## 升序
select `field1`, `field2` [, ...] from `tb_name` order by `field` desc; ## 降序
没有排序的查询其返回的顺序是未定义的。NULL视为比任何值都小的值。
2.7 where子句
| 比较运算符 | 解释 |
|---|---|
| > , >= , < , <= | 大于,大于等于,小于,小于等于 |
| = | 等于,NULL不安全,例如 NULL = NULL 的结果是 false(0) |
| <=> | 等于,NULL安全,例如 NULL <=> NULL 的结果是 true(1) |
| != , <> | 不等于 |
| between a0 and a1 | 范围匹配,满足 [a0, a1] 区间,返回 TRUE(1) |
| in (option …) | 如果是 option 中的任意一个,返回 TRUE(1) |
| is null | 是NULL |
| is not null | 不是NULL |
| like | 模糊匹配。% 表示任意(>=0)个字符, _ 表示任意一个字符 |
| 逻辑运算符 | 解释 |
| and | 与,多个条件必须都为 true(1),结果才是 true(1) |
| or | 或,任意一个条件为 true(1),结果为 true(1) |
| not | 非,条件为 true(1),结果为 false(0) |
select `field` from `tb_name` where `field` between `data1` and `data2`;select `field` from `tb_name` where `field` in (`data1`,`data2`);select `field` from `tb_name` where `field` like 'data%'; ## 模糊匹配%多个
select `field` from `tb_name` where `field` like 'data_'; ## 模糊匹配_单个2.8 分页查询
## 筛选下标从0开始
select `field` [, ...] from `tb_name` limit `n`; ## 从0开始筛选n条记录
select `field` [, ...] from `tb_name` limit `s`, `n`; ## 从s开始筛选n条记录
select `field` [, ...] from `tb_name` limit `n` offset `s`; ## 从s开始筛选n条记录
4.3 Update
update是对查询到的结果进行列值更新。
update `tb_name` set column = expr, column = expr, ...
	[where ...]
	[order by ...]
	[limit ...]
4.4 Delete
删除表
delete from `tb_name`
	[where ...]
	[order by ...]
	[limit ...]
截断表
truncate [table] `tb_name`;目前来看,delete只会将表内容清除,不会清空表中字段的自增记录,而truncate会。
4.5 插入查询结果
insert into `tb_bak` select * from `tb_name`; ## 插入查询结果通常可以用来对表去重。
## 1. 建立备份表
create table duplicate_table_bak like duplicate_table;
## 2. 将去重结果导入备份表
insert into duplicate_table_bak  select distinct * from duplicate_table;
## 3. 删除表
rename table duplicate_table to old_duplicate_table;
## 4. 转正备份表
rename table duplicate_table_bak to duplicate_table;
4.6 聚合函数
聚合函数的使用更多时关注数据纵向之间的关系。
| 函数 | 说明 |
|---|---|
| COUNT ( [DISTINCT] expr ) | 返回查询到的数据的数量 |
| SUM ( [DISTINCT] expr ) | 返回查询到的数据的总和,不是数字没有意义 |
| AVG ( [DISTINCT] expr ) | 返回查询到的数据的平均值,不是数字没有意义 |
| MAX ( [DISTINCTl expr ) | 返回查询到的数据的最大值,不是数字没有意义 |
| MIN ( [DISTINCT] expr ) | 返回查询到的数据的最小值,不是数字没有意义 |
4.7 group by
select colum1, colum2, ... from table group by `column`, ...;分组的目的是便于对其进行聚合统计。group by首先要对全部数据进行分组,分完组后再针对每组数据执行相同的操作。
4.8 having
having用来对聚合后的数据进行筛选。
select `colum1`, ... from table group by `column` having `condition`;where子句几乎是最早被执行,不可能去筛选group by分组之后的数据。
4.9 OJ练习
- https://www.nowcoder.com/practice/51c12cea6a97468da149c04b7ecf362e
- https://www.nowcoder.com/practice/ae51e6d057c94f6d891735a48d1c2397
- https://www.nowcoder.com/practice/218ae58dfdcd4af195fff264e062138f
- https://www.nowcoder.com/practice/ec1ca44c62c14ceb990c3c40def1ec6c
- https://www.nowcoder.com/practice/6d4a4cff1d58495182f536c548fee1ae
- https://www.nowcoder.com/practice/4c8b4a10ca5b44189e411107e1d8bec1
- https://www.nowcoder.com/practice/72ca694734294dc78f513e147da7821e
- https://leetcode.com/problems/duplicate-emails/description/
- https://leetcode-cn.com/problems/big-countries/description/
- https://leetcode.com/problems/nth-highest-salary/description/
5. 内置函数
内置函数一般放在SQL语句里帮助我们执行一些逻辑。
5.1 日期函数
| 函数名称 | 描述 |
|---|---|
| current_date() | 获取当前日期 |
| current_time() | 获取当前时间 |
| current_timestamp() | 获取当前时间戳 |
| date(datetime) | 返回datetime的日期部分 |
| time(datetime) | 返回datetime的时间部分 |
| date_add (date, interval x day) | 在date中添加日期或时间,单位可为年月日时分秒 |
| date_sub (date, interval x day) | 在date中减去日期或时间,单位可为年月日时分秒 |
| datediff (date2, date1) | 两个日期的差,单位是天 |
| now() | 当前日期时间 |
5.2 字符串函数
| 字符串函数 | 说明 |
|---|---|
| charset ( str ) | 获取字符串字符集 |
| concat ( string1, ...) | 拼接字符串 |
| length ( string ) | 返回字符串的字节数 |
| replace ( str, search_str, replace_str ) | 将字符串中的 replace_str 替换 search_str |
| substring ( str, position [, length] ) | 从字符串的postion位置开始截取length个字符 |
| ucase ( string ) | 转换成大写 |
| lcase ( string ) | 转换成小写 |
| instr ( string, substr ) | 返回substr在string中出现的位置,没有返回0 |
| left ( string, length ) | 从string中的左边起截取length个字符 |
| strcmp ( string1.string2 ) | 逐字符比较两字符串大小 |
| ltrim ( string ) rtrim ( string ) trim ( string ) | 去除前或后或前后空格 |
5.3 数学函数
| 数学函数 | 描述 |
|---|---|
| abs ( number ) | 绝对值函数 |
| bin ( decimal number ) | 转换二进制 |
| hex ( decimalNumber ) | 十六进制 |
| Iconv ( number, from_base, to_base ) | 指定进制转换 |
| ceiling ( number ) | 向上去整 |
| floor ( number ) | 向下去整 |
| format ( number, decimal_places ) | 格式化,保留小数位数 |
| rand () | 返回随机浮点数,范围 [ 0.0, 1.0 ) |
| mod ( number, denominator ) | 取模 |
5.4 其他函数
| 其他函数 | 描述 |
|---|---|
| user () | 返回当前用户 |
| md5 ( string ) | 对字符串进行md5摘要 |
| database () | 返回当前数据库 |
| password ( string ) | 对用户加密 |
| ifnull ( string1, string2 ) | 如果string1不为null则返回string1,否则返回string2 |
6. 复合查询
6.1 多表查询
select * from `tb_1`, `tb_2`
	where dept.deptno = emp.deptno;
不加过滤条件,得到的结果被称为笛卡尔积。本质是取主表的每一条记录拼接上从表的每一条记录。
多表查询中一定会包含where条件,将主键和外键对应,可以将无意义的记录抛弃。
6.2 自连接
同一张表自己和自己拼接的叫做自连接。给两张相同的表起别名,就可以放到一起。
select * from emp wkr, emp ldr;
	where wkr.mgr = ldr.empno;
自连接的话,需要根据实际需求筛去不满足条件的数据。
6.3 子查询
子查询也称嵌套查询,也就是将select的结果作为另一个select的条件。
单行子查询
返回一行记录的查询称为单行子查询。
select * from emp where deptno=(select deptno from emp where ename='SMITH');多行子查询
返回多行记录的查询称为多行子查询。关键字有:in,all,any。
- in 表示是否存在于集合中,存在即满足条件。
- all 表示整个集合的每一个结果
- any 表示集合中的任意一个结果
## 显示和10号部门具有的工作岗位相同的员工
select * from emp where job in (select distinct job from emp where deptno=10);
## 显示工资比10号部门所有人工资都高的员工
select * from emp where sal > all (select distinct sal from emp where deptno=10);
## 显示工资比10号部门任意员工工资高的员工
select * from emp where sal > any (select distinct sal from emp where deptno=10);
不管是单行还是多行子查询,都叫做单列子查询,返回的都是单列的一个字段的数据。
多列子查询
## 查询和SMITH的部门和岗位完全相同的所有雇员
select * from emp where (deptno, job)=(select deptno, job from emp where ename='SMITH');
from中使用子查询
from跟是的表名,既然我们查询出来的记录都可以看作表结构。这里就是一个数据查询的技巧,把子查询当作临时表使用。
## 显示每个高于自己部门平均工资的员工的姓名、部门、工资、平均工资
select ename, emp.deptno, sal, myavg
	from emp,
			 (select deptno, avg(sal) as myavg from emp group by deptno) as avg_tb
	where emp.deptno=avg_tb.deptno and sal>myavg;

## 显示每个部门的部门名,编号,地点和人员数量
select dname, dept.deptno, loc, cnt
	from emp, dept,
			 (select deptno, count(*) cnt from emp group by deptno) as cnt_tb
	where cnt_tb.deptno=emp.deptno and cnt_tb.deptno=dept.deptno;
合并查询
合并查询是就是合并多个 select 的查询结果,可使用集合操作符 union,union all。
| 关键字 | 解释 |
|---|---|
| union | 取并集,将多个 select 结果合并到一起,自动去掉重复行 |
| union all | 取并集,将多个 select 结果合并到一起,但不去重 |
select * from emp where sal > 2500 union     select * from emp where job='MANAGER';
select * from emp where sal > 2500 union all select * from emp where job='MANAGER';
6.4 OJ连接
- https://www.nowcoder.com/practice/23142e7a23e4480781a3b978b5e0f33a
- https://www.nowcoder.com/practice/355036f7f0c8429a85281f7ac05b457a
- https://www.nowcoder.com/practice/32c53d06443346f4a2f2ca733c19660c
- https://www.nowcoder.com/practice/e50d92b8673a440ebdf3a517b5b37d62
7. 内外连接
7.1 内连接
内连接就是利用where对笛卡尔集进行筛选,我们前面使用的就是内连接。这样的写法更加规范。
select `field` from `tb_1` inner join `tb_2` on 连接条件 and 其他条件;7.2 外连接
外连接分为左外连接和右外连接。左外连接以左表为主,右外连接以右表为主。
副表中缺少和主表匹配的数据,则该部分显示为空。附表中多余而匹配不上的数据,抛弃不作显示。
select `field` from `tb_1` left  join `tb_2` on 连接条件 and 其他条件;
select `field` from `tb_1` right join `tb_2` on 连接条件 and 其他条件;
外连接就是为了显示出匹配不上的数据,从而确定哪些数据不满足条件。
7.3 OJ练习
8. 视图
视图是一个不怎么重要不怎么常用的机制。
视图是一个虚拟表,其内容由查询定义。视图和真实的表一样,包含一系列带有名称的列和行数据,
8.1 基本使用
create view `view_name` as select ...;创建视图就相当于创建一张表,并且也以文件的形式保存在MySQL目录中。

但文件只保存了结构没保存数据,每次查看视图都会临时从表中获取数据。这样有个好处是视图的数据变化会影响到基表,基表的数据变化也会影响到视图。

8.2 视图规定和限制
- 与表一样,必须唯一命名(不能出现同名视图或表名)
- 创建视图数目无限制,但要考虑复杂查询创建为视图之后的性能影响
- 视图不能添加索引,也不能有关联的触发器或者默认值
- 视图可以提高安全性,必须具有足够的访问权限
- order by 可以用在视图中,但是如果从该视图检索数据 select 中也含有 order by,那么该视图中的 order by 将被覆盖
9. 用户管理
用户管理的思路都是大同小异,可以类比Linux用户管理。
9.1 用户信息
MySQL中用户信息都在库mysql的user表中。
| 字段 | 解释 |
|---|---|
host | 这个用户的允许登陆地,如果是localhost表示本地,%表示任意 |
user | 用户名 |
authentication_string | 用户密码通过password函数加密后的结果 |
*_priv | 用户拥有的权限,后面跟Y表示允许,N表示拒绝 |
创建用户
create user 'username'@'ip' identified by 'password';

SHOW VARIABLES LIKE 'validate_password%';
set global validate_password.check_user_name=0;
set global validate_password.policy=0;
set global validate_password.special_char_count=0;
SHOW VARIABLES LIKE 'validate_password%';
用户被创建好,也无法进行大部分操作,需要对用户进行赋权。
删除用户
drop user '用户名'@'主机名';修改用户密码
## 自行修改密码
set password=password('新的密码');
## root用户修改其他用户密码
set password for '用户名'@'主机名'=password('新的密码');
9.2 用户权限
| 权限 | 字段 | 上下文 |
|---|---|---|
| CREATE | Create_priv | 数据库、表或索引 |
| DROP | Drop_priv | 数据库、表 |
| GRANT OPTION | Grant_priv | 数据库、表或保存的程序 |
| REFERENCES | References_priv | 数据库或表 |
| ALTER | Alter_priv | 表 |
| DELETE | Delete_priv | 表 |
| INDEX | Index_priv | 表 |
| INSERT | Insert_priv | 表 |
| SELECT | Select_priv | 表 |
| UPDATE | Update_priy | 表 |
| CREATE VIEW | Create_view_priy | 视图 |
| SHOW VIEW | Show_view_priv | 视图 |
| ALTER ROUTINE | Alter_routine_priy | 保存的程序 |
| CREATE ROUTINE | Create_routine_priv | 保存的程序 |
| EXECUTE | Execute_priv | 保存的程序 |
| FILE | File_priv | 服务器主机上的文件访问 |
| CREATE TEMPORARY TABLES | Create_tmp_table_priv | 服务器管理 |
| LOCK TABLES | Lock_tables_priv | 服务器管理 |
| CREATE USER | Create_user_priv | 服务器管理 |
| PROCESS | Process_priv | 服务器管理 |
| RELOAD | Reload_priv | 服务器管理 |
| REPLICATION CLIENT | Repl_client_priv | 服务器管理 |
| REPLICATION SLAVE | Repl_slave_priv | 服务器管理 |
| SHOW_DATABASES | Show_db_priy | 服务器管理 |
| SHUTDOWN | Shutdown_priy | 服务器管理 |
| SUPER | Super_priv | 服务器管理 |
用户赋权
grant 权限列表 on 库.对象名 to '用户名'@'登陆IP' [ identified by '密码' ];赋权之后如果没反应,需要进行刷新权限:
flush privileges;
如果嫌麻烦的话可以直接把权限列表写成all。
grant all on *.* to '用户名'@'登陆IP';回收权限
revoke 权限列表 on 库.对象名 from '用户名'@'登陆IP';10. C语言接口
10.1 安装环境
要想使用C/C++的MySQL接口,必须使用MySQL提供的库。如果当初是用yum安装MySQL的直接就有。

如果没有目录/usr/include/mysql,可以安装如下两个程序
## centos
$ rpm --import https://repo.mysql.com/RPM-GPG-KEY-mysql-2022 ## 如果出现GPG key不匹配的问题
$ yum install -y libodb-mysql-devel.x86_64
$ yum install -y soci-mysql-devel.x86_64

## ubuntu
$ apt install mysql-client
$ apt install libmysqlclient-dev
链接静态库的时候,要指明库名和路径。
## centos
mysql_test:mysql_test.cc
		g++ -o $@ $^ -lmysqlclient -L/usr/lib64/mysql -std=c++11
## ubuntu
mysql_test:mysql_test.cc
		g++ -o $@ $^ -lmysqlclient -L/usr/lib/mysql   -std=c++11
这里有一个坑,库所在路径一定要指明
/usr/lib*/mysql,如果找不到的话。
10.2 接口介绍
创建关闭句柄
//0. 创建MYSQL句柄
MYSQL* my = mysql_init(nullptr);
//4. 关闭数据库
mysql_close(my);
由此也可以看出MySQL其实是网络服务,句柄就是文件描述符。
连接数据库
//1. 连接MYSQL
char* host   = "127.0.0.1";
char* user   = "test";
char* passwd = "testtest123456!";
char* db     = "102_db";
int   port   = 3306;

if (mysql_real_connect(my, host, user, passwd, db, port, nullptr, 0) == nullptr) {
	std::cout << "connect failed" << std::endl;
	exit(1);
}
std::cout << "connect success" << std::endl;
设置字符编码
//2. 设置字符编码
mysql_set_character_set(my, "utf8");
设置字符编码为utf8,防止乱码。
执行SQL语句
//3. 执行SQL语句
// 增删改
std::string sql = "insert into account values (5, '猪八戒', 8.22)";
std::string sql = "delete from account where id=5";
std::string sql = "update account set name='唐僧' where id=5";
// 查
std::string sql = "select * from account";

int res = mysql_query(my, sql.c_str());
if (res != 0) {
	std::cout << "execute: " << sql << " failed" << std::endl;
	exit(2);
}
传入SQL语句,返回值为0表示成功,为1表示失败。
增删改SQL执行完就完了,如果是查询select语句我们还要读取结果。
获取查询结果
// 获取执行结果
MYSQL_RES* result = mysql_store_result(my);依靠句柄获取最新一次查询结果,返回到MYSQL_RES结构体中。
同时该函数malloc了一块内存空间来存储查询过来的数据,所以一定要释放对应空间不然会造成内存泄漏。
获取行数列数
// 获取行数列数
int rows = mysql_num_rows(result);
int cols = mysql_num_fields(result);
std::cout << "行数: " << rows << " 列数: " << cols << std::endl;
获取字段名称
// 获取字段名称
MYSQL_FIELD* fields = mysql_fetch_fields(result);
for (int i = 0; i < cols; i++) {
	std::cout << fields[i].name << "\t";
}
std::cout << std::endl;
获取一行记录
//遍历获取记录
for (int i = 0; i < rows; i++) {
	MYSQL_ROW line = mysql_fetch_row(result);
	for (int j = 0; j < cols; j++) {
		std::cout << line[j] << "\t";
	}
	std::cout << std::endl;
}mysql_fetch_row返回值就是一个char*的数组,保存的是一条记录中的每个字段值。
11. 索引
11.1 索引原理
索引是一个“物美价廉”的特性,用来提高数据库的性能。不需要改程序、调SQL、只需要正确的创建索引,查询速度就能提高成百上千倍,但也带来了增删速度的下降。
MySQL中的数据是以Page为单位保存在内存中的。Page之间使用前后指针构成双向链表。Page结构体内部多条记录也是使用链表形式存储。
如果存在主键,MySQL会自动将我们插入的数据,按主键的递增顺序进行排序。便于优化查询的效率。首先数据得有序才能方便查找。
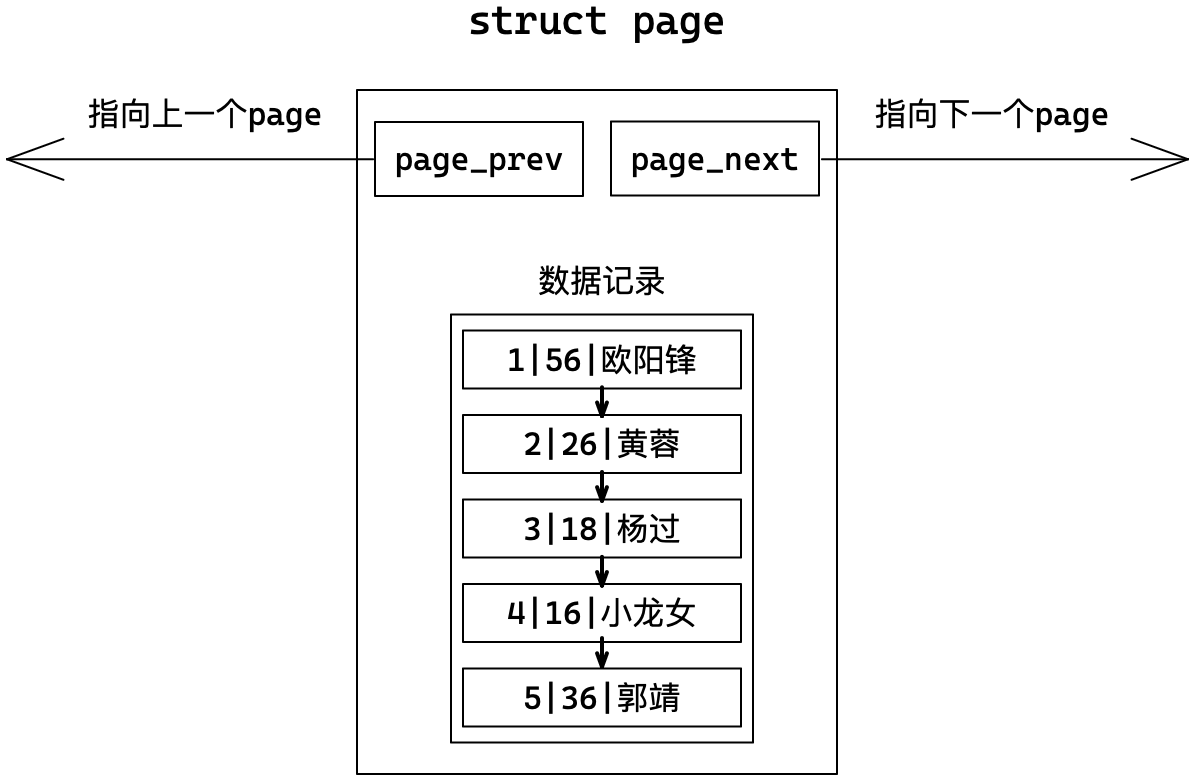
主键索引
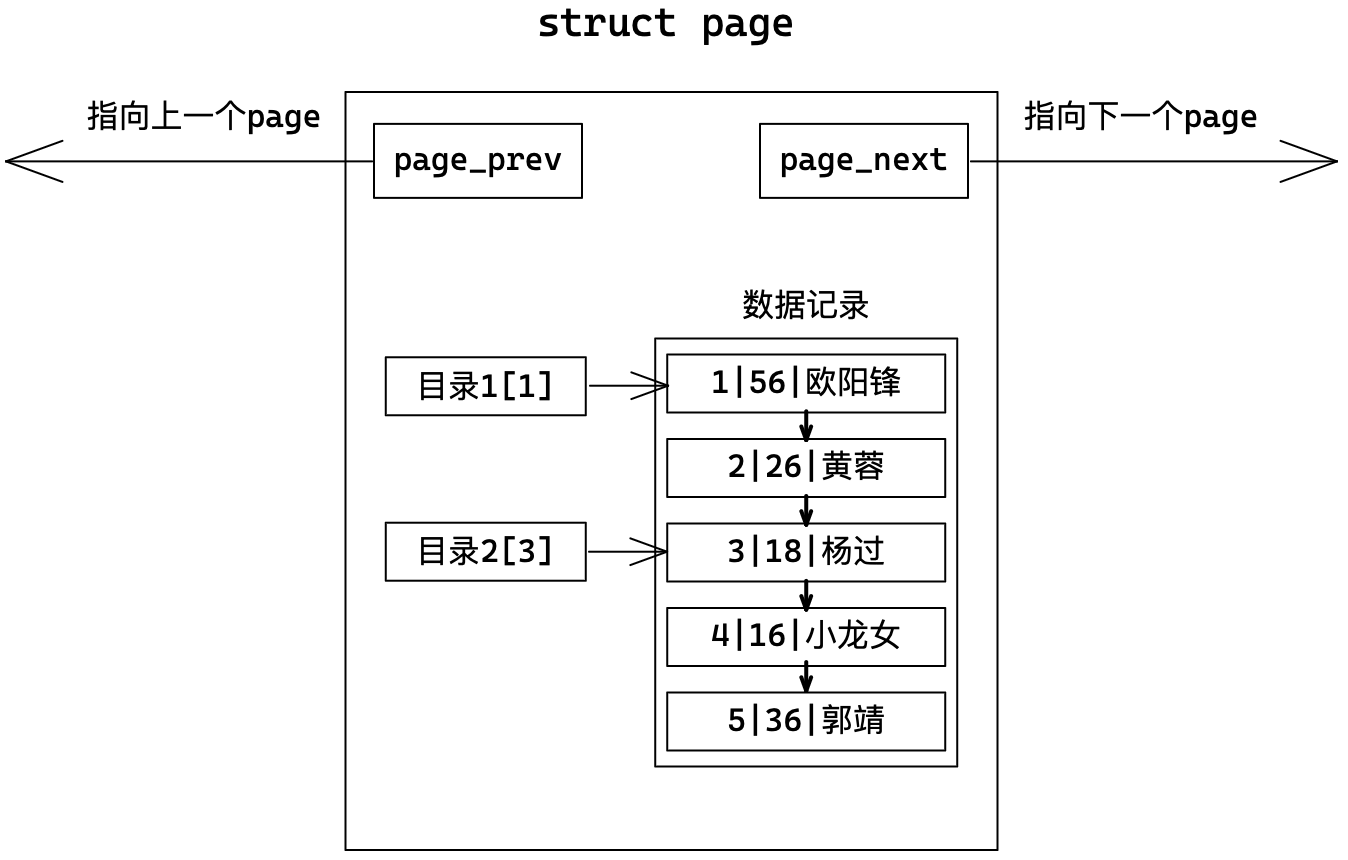
如何提高在单个Page中的查找效率?
针对单页Page我们可以添加“目录”,目录存储所指向的记录的键值,这是一种以空间换时间的做法,但是建立在数据有序的基础上。
如何提高在多个Page中的查找效率?
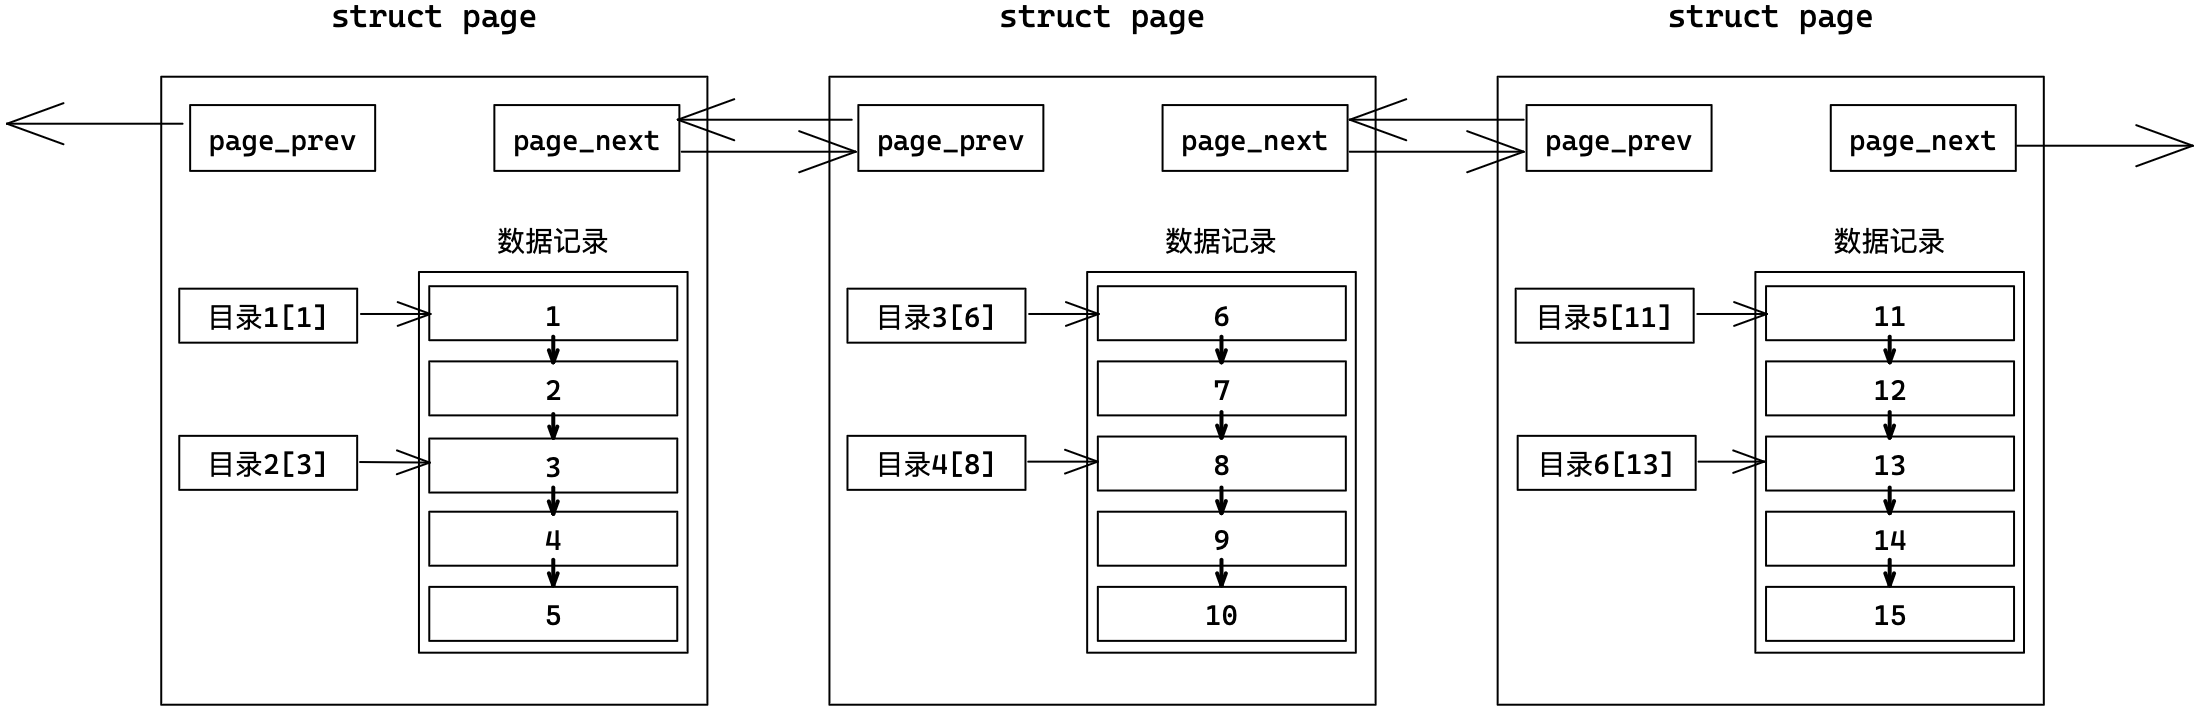
Page以链表的形式组织,只能线性遍历也有效率问题。
解决方法是为多个数据页配一个目录页,该目录页存储所指向的数据页的最小键值。
目录页也是页,普通页存储的是用户数据,目录页存储的是普通页的地址。这样一次查找就能排除多页,效率更高。
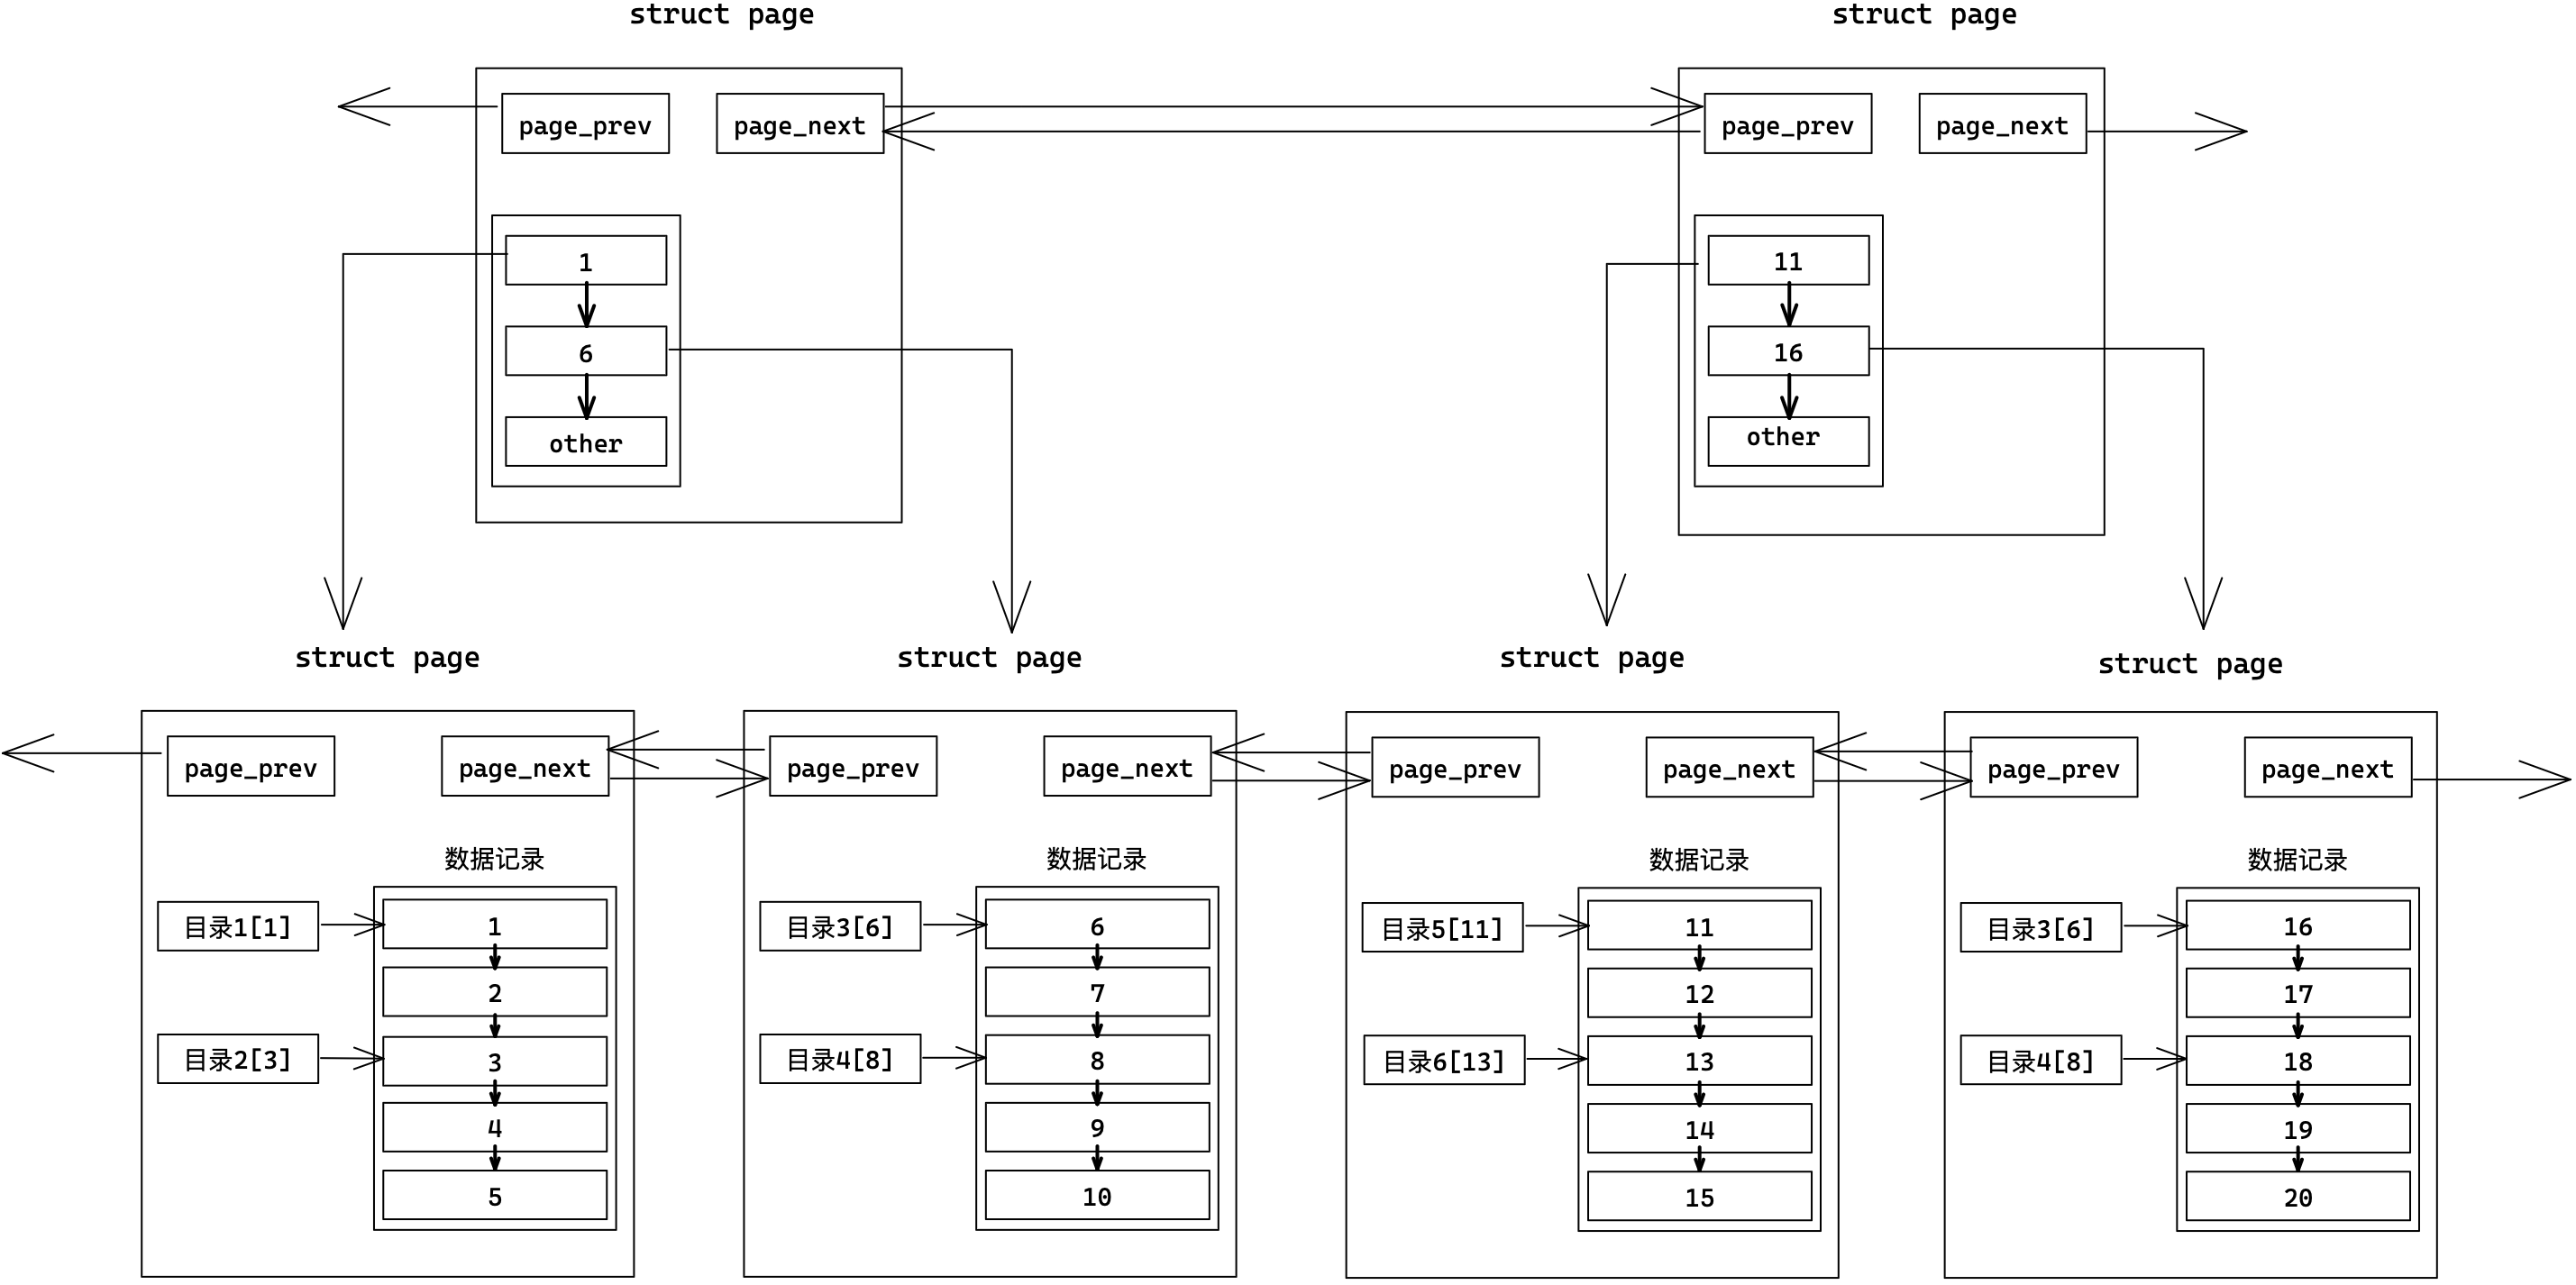
不过我们还需要一个管理页(可能是多个)存储其下所有目录页的最小键值,用来来管理其下所有目录页。这样每次查找从顶层管理页开始,逐步向下查找,这也就是B+树模型。
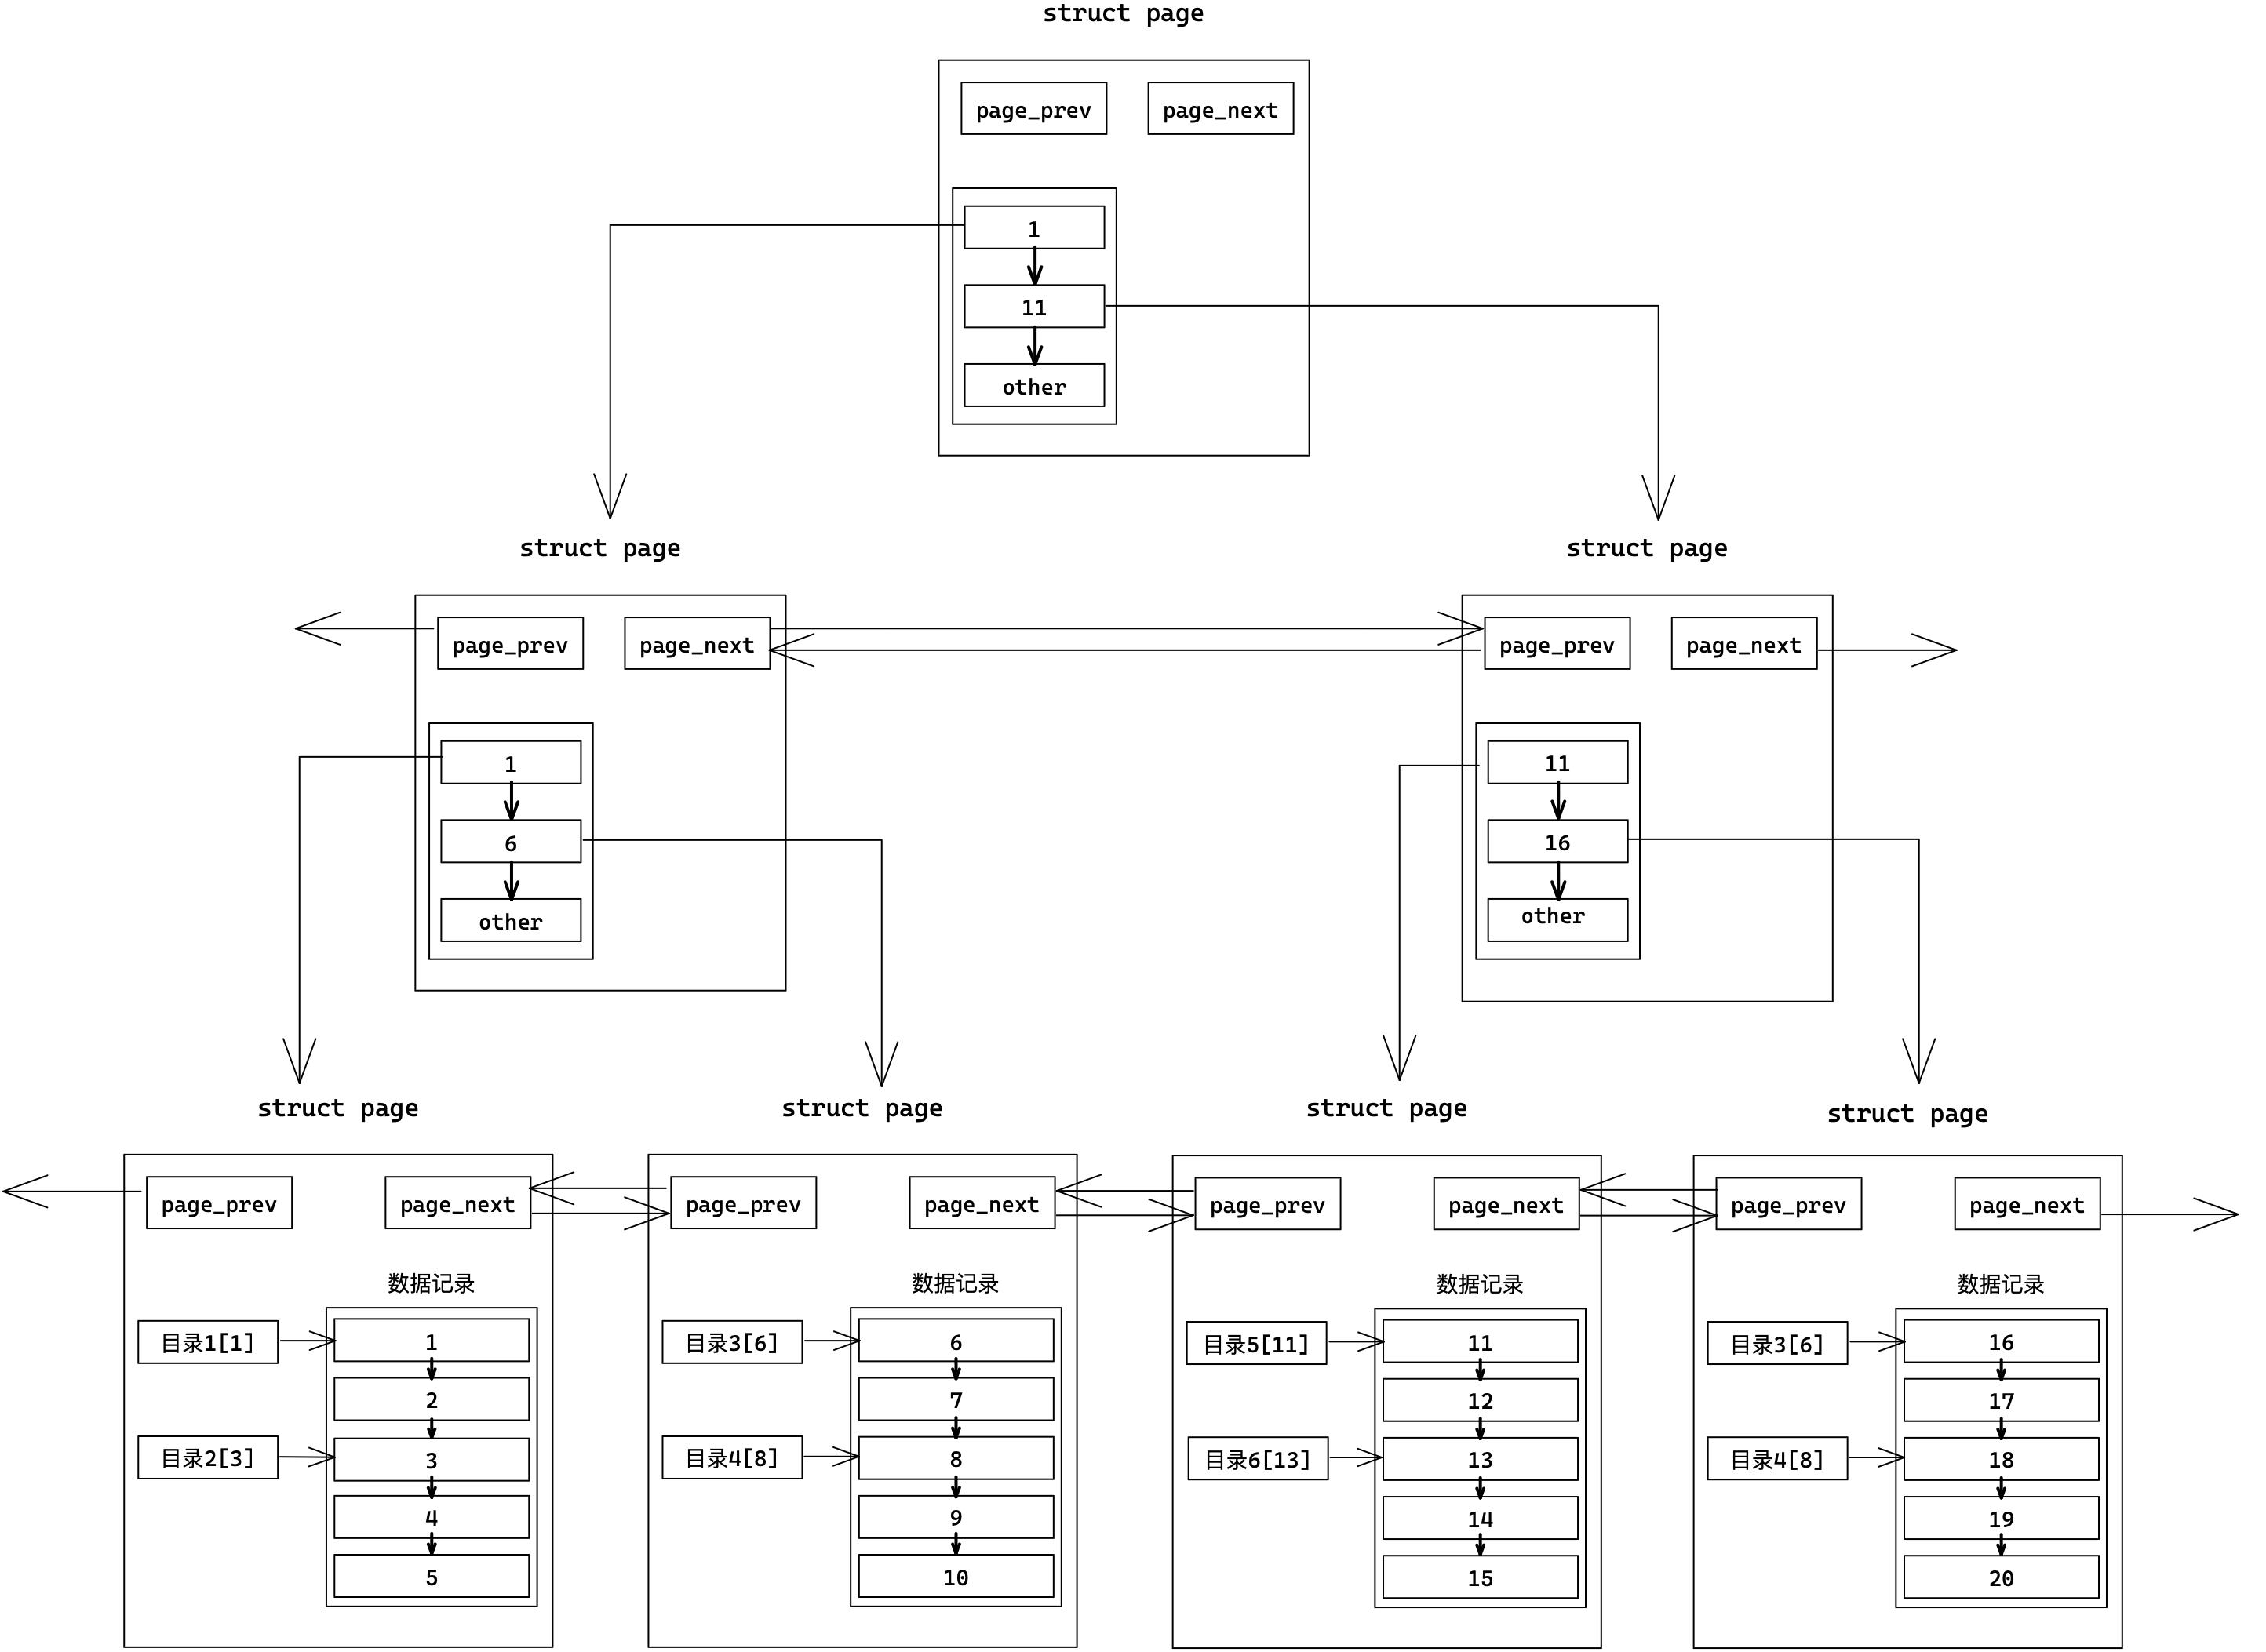
所谓索引,就是在MySQL内部,用页存储数据,再用B+树组织所有Page页。
- 叶节点存储数据,非叶节点只存目录。
- 自顶向下找,只要加载部分目录页,即可遍历整个树,大大减少了IO次数。
B+树方案解决两个问题:线性遍历和大量IO。缺点是略降增删的效率,因为插入或删除会破坏树的结构。
为什么选择B+树,而不是其他数据结构?
| 数据结构 | 劣势 |
|---|---|
| 链表 | 只能线性遍历,效率太低 |
| 二叉搜索树 | 退化问题,可能退化成为线性结构 |
| AVL和红黑树 | 二叉结构导致树整体过高。需要加载Page就多IO效率低 |
| Hash | 散列随机的导致范围查找时效率不行 |
| B树 | 底层无法线性遍历,范围查找效率不高。树体存储数据导致树过高 |
聚簇索引和非聚簇索引
| 概念 | 存储引擎 | 解释 |
|---|---|---|
| 聚簇索引 | InnoDB | 叶节点存储数据 |
| 非聚簇索引 | MyISAM | 叶节点不存储数据,存储数据地址 |
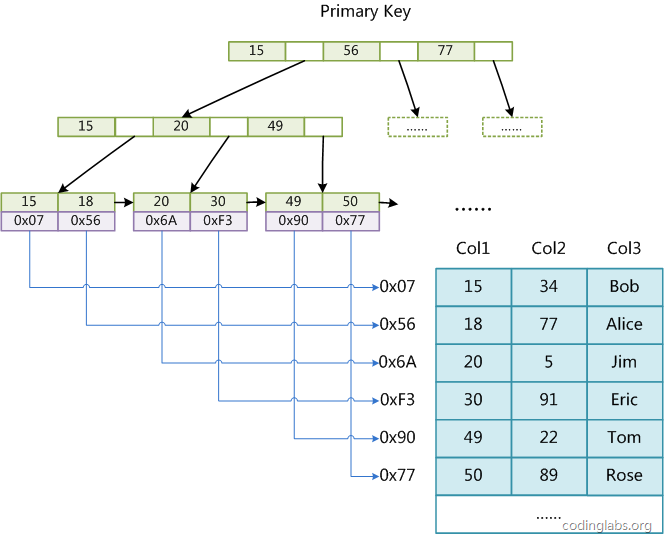
除了主键索引,用户也有可能以其他字段建立索引,一般这种索引叫做辅助索引或者普通索引。
- 对于MyISAM,建立普通索引和主键索引没有差别(叶节点都存放数据地址)
- 对于InnoDB,建立普通索引,叶结点保存该记录的主键,需要回表查询。
11.2 索引操作
主键索引
创建表的时候设置主键或者后期追加设置主键,都会自动创建主键索引模型。
create table `tb_name` (`field` datatype primary key); ## 方式一
create table `tb_name` ( rimary key (`field`)); ## 方式二
alter table `tb_name` add primary key (id); ## 方式三
唯一索引
create table `tb_name` (`field` datatype unique key); ## 方式一
create table `tb_name` (unique(`field`)); ## 方式二
alter table `tb_name` add unique key (id); ## 方式三
普通索引
create table `tb_name` (index(`field`)); ## 创建表时指定索引
create index `idx_name` on `tb_name`(`field`); ## 追加索引
alter table `tb_name` add index(`field`); ## 追加索引
查询索引
show index from `tb_name`\G删除索引
alter table `tb_name` drop primary key; ## 删除主键索引
alter table `tb_name` drop index `index_name`; ## 删除唯一索引或普通索引
2.7 索引创建原则
- 较频繁作为查询条件的字段应该作为索引
- 唯一性太差的字段不适合作为索引
- 更新较频繁的字段不适合作为索引
高频查,低频改,唯一性强
12. 事务
数据库也是临界资源,也需要考虑并发安全。
12.1 事务的概念
事务就是一组能保证原子性的sql语句,属于一个整体,要么全部失败要么全部成功。是MySQL提供一种机制,保证达到原子性的效果。
一个完整的事务需要满足四个特性:ACID
| 特性 | 解释 |
|---|---|
| 原子性 Atomicity | 事务提交失败,自动全部回滚,事务提交成功,数据持久化 |
| 持久性 Durability | 事务一旦提交成功,数据就持久化不可在回滚 |
| 隔离性 Isolation | 保证并发事务受到不同程度的隔离 |
| 一致性 Consistency | 事务结束后,数据从一个一致性状态变为另一个一致性状态 |
查看隔离级别
隔离级别有三个变量,分别是:全局隔离级别、会话隔离级别、默认隔离级别。
全局对所有人有效、会话对本次会话登陆有效、默认和会话等级一致。
SELECT @@GLOBAL.tx_isolation, @@tx_isolation;
SELECT @@GLOBAL.transaction_isolation, @@transaction_isolation; ## mysql8
+--------------------------------+-------------------------+
| @@GLOBAL.transaction_isolation | @@transaction_isolation |
+--------------------------------+-------------------------+
| REPEATABLE-READ                | REPEATABLE-READ         |
+--------------------------------+-------------------------+

set session transaction isolation level read committed;
事务的操作
start transaction; / begin; #1.启动事务

savepoint `point_name`; ## 设置回滚点

rollback to `point_name`; ## 回滚到回滚点
rollback ## 全部回滚

commit; ## 提交
12.2 原子性
MySQL会自动回滚未完成的事务,以此来维护事务的原子性。
当进行事务的一方突然发生异常,未能提交事务,那么MySQL将自动回滚,事务的操作会自动取消。反之一旦提交,数据变为永久状态。
实际上单条SQL也被包装成事务,所以如果突然退出,也会自动回滚。但前提是将MySQL的自动提交关闭。
持久性就是事务提交后,数据改动变成持久状态,无法在被回滚。
12.3 隔离性
多个事务同时运行的时候,一定会相互影响。保证事务的运行过程尽量不受干扰,也就是保证隔离性。
MySQL允许事务受到不同程度的干扰,就有描述隔离程度的重要概念:隔离级别。
| 隔离级别 | 解释 |
|---|---|
| 读未提交(Read Uncommitted) | 事务能读到其他事务未提交的结果,相当于没有隔离,可能导致脏读 |
| 读提交(Read Committed) | 一个事务只能读到其他事务提交后的结果,可能会造成不可重复读 |
| 可重复读(Repeatable Read) | 确保一个事务多次读取只会看到同样的数据,可能会造成幻读 |
| 串行化(Serializable) | 强制事务排序,不可能发生冲突,但可能会导致超时和锁竞争 |
大多数数据库的隔离级别都是读提交,MySQL默认的隔离级别是可重复读。
读未提交
读未提交,相当于没有锁,会产生很多问题。比如脏读,读到另一个执行中事务的未提交的修改就叫脏读。实际生产环境是不会使用的。
读提交
读提交可能会导致一个事务的两次读取,读到的结果不一样。这个现象就是不可重复读。
不可重复读问题在于,不应让与当前事务并行的事务也读到修改后的数据,造成事务读取前后不一致,会影响自身上层业务逻辑。
可重复读
可重复读是MySQL的默认隔离级别。就算修改事务已经提交,其他同时存在的事务也无法看到修改的数据。也就是屏蔽与自身并发的事务所做出的修改。
一般的数据库只能屏蔽修改删除,屏蔽不了插入操作。因为隔离性是通过给记录加锁实现的,但新增数据是不存在的,也就无法预先加锁。多次读取读到新增数据,这种现象叫做幻读。
但MySQL可以屏蔽插入操作,通过Next-Key间隙锁的机制解决的,具体不做讨论。
串行化
对所有修改操作加锁进行串行化,不会存在任何问题,但是效率很低。如果并发事务一方进行写入等操作,该事务就会被阻塞住,会被定时解锁。
总结
事务具有隔离性是为了安全,种类繁多的隔离机制是为了兼顾效率。
隔离级别越严格,安全性越高,但数据库的并发性能也就越低。
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 加锁读 |
|---|---|---|---|---|
| 读未提交 | 脏读 | 不可重复读 | 幻读 | 不加锁 |
| 读提交 | 不可重复读 | 幻读 | 不加锁 | |
| 可重复读 | 不加锁 | |||
| 串行化 | 加锁 |
12.4 一致性
事务执行前后,数据库都是从一个一致性状态变到另一个一致性状态。
当事务成功提交,数据库处于一致性状态。当事务未提交且已经对数据库做出修改,此时数据库就处于不正确不一致状态。
一致性表达的意思是,数据库中的数据保持一致状态,数据可有变化,但数据是有意义的。
一致性并不是MySQL中真实存在的一种具体状态,是由原子性、持久性、隔离性共同保证数据库处于一致性的状态。
一致性和用户业务逻辑相关,MySQL提供技术支持,但一致性由上层业务和底层MySQL共同决定。
12.5 隔离性理解
数据库并发场景有三种,读读: 不需要并发控制,写写:只能加锁串行化。读写:有线程安全问题,可能会造成事务隔离性问题,如脏读、幻读、不可重复读。
MVCC
多版本并发控制(MVCC)是一种用来解决读写冲突的无锁并发控制。
MySQL会为事务分配单向增长的事务ID,为每个修改保存一个版本,版本与事务ID关联。读操作只读该事务开始前的数据库的快照。
所以MVCC可以解决以下问题:
- 在并发读写时,无需阻塞读写操作,提高了数据库并发读写的性能。
- 同时还可以解决脏读,幻读,不可重复读等事务隔离问题,但不能解决更新丢失问题。
3个隐藏字段
| 字段 | 解释 |
|---|---|
| DB_TRX_ID | 6字节,保存最近修改本条记录的事务ID |
| DB_ROLL_PTR | 7字节,回滚指针,指向本条记录的历史版本 |
| DB_ROW_ID | 6字节,隐藏主键,如果没有主键,InnoDB会自动以DB_ROW_ID产生一个聚簇索引 |
undo log
undo log是由MySQL开辟的一段内存,用来保存历史记录的。每一条记录被修改时,都会改前先备份一遍放在undo log中,依靠回滚指针一条一条链起来。
这样,我们就有了一个基于链表记录的历史版本链。所谓回滚,就是用历史数据覆盖当前数据。一个个版本,称之为一个个的快照。
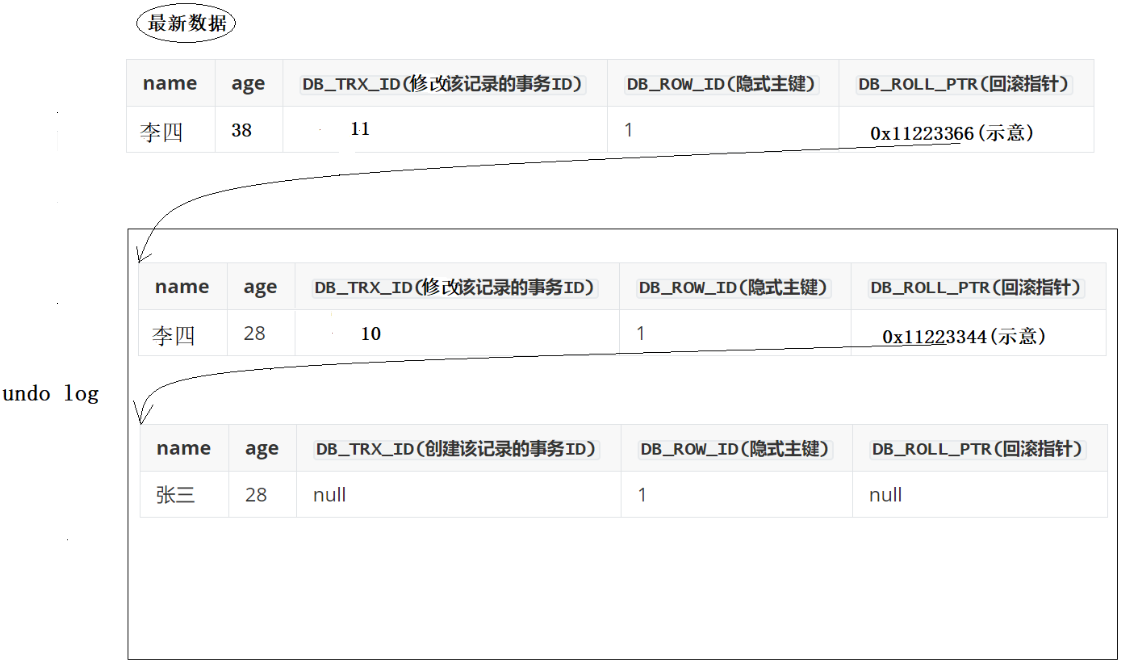
添加undo log
当前事务想要修改记录时,会先给该记录加锁,并将记录拷贝一份放到undo log中保存,再解锁并将记录中的回滚指针字段指向undo log中的上一条记录。
改完之后的记录就成了最新纪录,而undo log中的就是历史记录。
删除操作是将隐藏字段flag置为删除,如此也可以形成历史版本。如果是插入操作,新增记录没有历史记录,可以在undo log中放一条空记录即可维护历史版本。
删改的永远都是最新纪录,而查询的可能是历史记录。
清空undo log
对于插入操作,自身提交后,就可以清空undo log中的插入历史纪录了,因为新增数据其他并发事务是看不见的,不需要维护隔离性。
但对于更新和删除操作,如果提交后清空undo log,其他并发事务还可能正在读取历史,只能等并发事务全部提交后才能清空。
隔离性的实现
在可重复读隔离级别下,一个事务看不到其他并发事务已经提交的更改,是因为并发事务删改的是最新纪录,而当前事务只能查询到历史版本,这就是隔离性的实现。那具体看到是哪一个历史版本,就是隔离级别不同的原因。
| 读取方式 | 解释 |
|---|---|
| 当前读 | 增删改必须是访问最新记录,读取最新记录都可以称为当前读。 |
| 快照读 | 读取undo log中的历史版本,就称为快照读 |
- 隔离级别中的串行化,也就是并发事务增删改查操作都要加锁,都是当前读,不需要历史版本。
- 而对于隔离级别中的可重复读,并发事务进行查询操作时都是读取历史版本的,就不需要加锁限制了,可以并行执行,提高了效率这就是MVCC的意义所在。
事务是具有原子性的,事务能够看到的内容、哪些事务所做的修改、整个数据库数据的情况,可以认为在事务分配事务ID时就确定了。
在此之后数据库发送的变化,该事务是看不见的,这就是隔离性的实现目标。各个事务能看到什么不能看到什么,这就是隔离性和隔离级别所要解决的问题。
那这样的隔离性策略如何实现的呢?
Read View
事务具体可以理解为MySQL的对象,Read View就是对象的成员。Read View 是事务进行快照读操作时产生的一种数据结构。
它是MySQL用来管理事务数据读取的可见性的机制,可以认为它就是“快照”,它描述了事务所能看到的数据库情况。具体是,Read View 将系统当前活跃的事务ID记录下来,加上其中的机制,就能够判断当前事务能够看到哪个版本的数据。
我们在源码层面简化探究一下Read View的实现机制。
class ReadView {
	//...
private:
	trx_id_t m_low_limit_id;   // 高水位ID,大于等于该ID的事务均不可见

	trx_id_t m_up_limit_id;    // 低水位ID,小于该ID的事务均可见

	trx_id_t m_create_trx_id;  // 创建该Read View的事务ID

	ids_t m_ids;               // 创建该Read View时活跃事务ID的列表
	//...
};- 低水位
m_up_limmit_id保存的是m_ids中记录的最小的事务ID; - 高水位
m_low_limmit_id保存的是m_ids中记录的最大事务ID+1; m_create_trx_id意思是创建该Read View的事务ID,也就是本事务的事务ID。
如何判断undo log中的历史版本记录是否能够被本事务读取看到呢?
- 如果历史版本的记录中的隐藏字段
DB_TRX_ID大于等于高水位m_low_limmit_id,说明该记录对本事务不可见。 - 如果
DB_TRX_ID小于低水位m_up_limmit_id或等于当前事务IDm_create_trx_id,说明该记录对本事务可见。 - 如果
DB_TRX_ID在高低水位之间且在m_ids中,说明该事务在创建快照时未提交,如果不在m_ids中,说明该事务在创建快照时已经提交。如果已提交当前事务就能看到其所做的修改,反之则不能。

准确的来说,事务能够看到的历史记录,在快照创建的一瞬间就确定好了。快照创建的时间就是事务首次进行select查询操作的时间,快照一旦建立好就不在变化,此时该事务所能看到的数据也就不会发生变化了。
bool changes_visible(trx_id_t id, const table_name_t& name) const
{
	if (id < m_up_limmit_id || id == m_creator_trx_id) {
		return true;
	}

	if (id >= m_low_limmit_id) {
		return false;
	} else if (m_ids.empty()) {
		return true;
	}

	return !std::binary_search(m_ids.data(), m_ids.data() + m_ids.size(), id);
}
RR和RC的本质区别
事务中快照读的结果是由该事务首次出现快照读的时机所决定,即某个事务中首次出现快照读,决定该事务后续快照读结果的能力。
Read View 不变,快照读所能读到的东西也就不变。
- RR级别下,快照读生成Read View时,Read View会记录此时所有其他活动事务的快照,此后Read view不在发生变化,故以后再进行快照读都读的内容是固定的。
- RC级别下,事务每次快照读都会新生成一个快照和Read View。这就是在RC级别下的事务可以看到别的事务提交的更新的原因。
总之在RC隔离级别下每个快照读都会生成最新的Read View;在RR隔离级别下是同一个事务中的第一个快照读才会创建Read View,之后的快照读获取的都是同一个Read View。
正是RC每次快照读都会形成Read View,才会有不可重复读问题。